ডেটা লেবেলিং ও ডেটা অগমেন্টেশন: কাঁচা ডেটা থেকে মেশিন লার্নিংয়ের জন্য প্রস্তুত ডেটাসেট
মেশিন লার্নিং প্রকল্পে শুধু ডেটা সংগ্রহ করলেই হয় না। ডেটাকে সঠিকভাবে লেবেলিং, পরিষ্কার, ভাগ এবং অগমেন্টেশন করতে হয়। এই লেখায় ডেটা লেবেলিং ও ডেটা অগমেন্টেশনের ধারণা, পার্থক্য, ব্যবহার, বাস্তব উদাহরণ এবং পাইথন ব্যবহার করে কীভাবে এগুলো করা যায় তা শুরু থেকে বিস্তারিতভাবে আলোচনা করা হয়েছে।
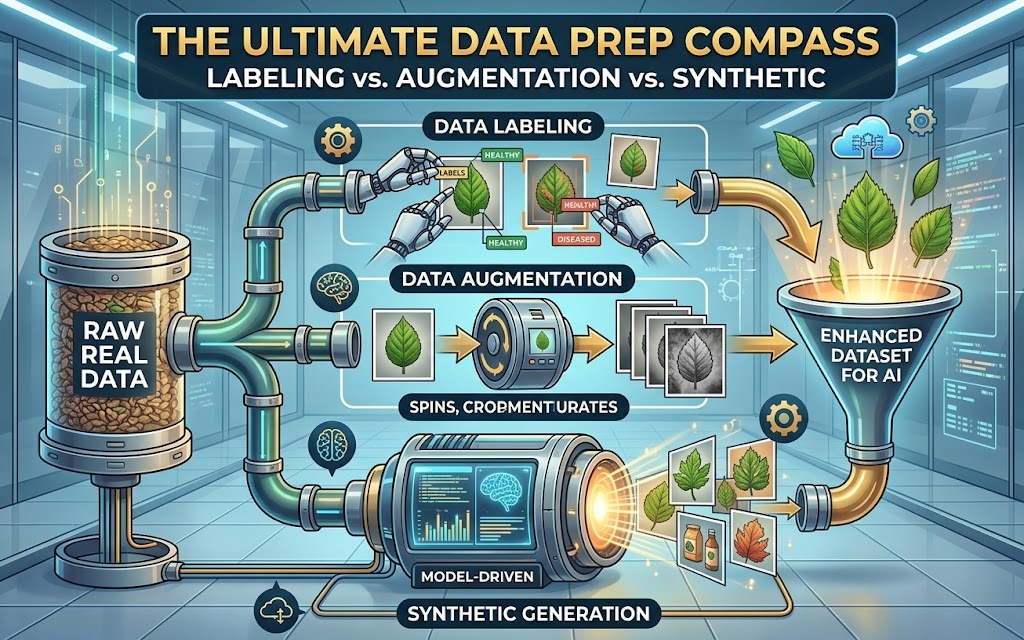
ডেটা লেবেলিং ও ডেটা অগমেন্টেশন: কাঁচা ডেটা থেকে মেশিন লার্নিংয়ের জন্য প্রস্তুত ডেটাসেট
মেশিন লার্নিং বা কৃত্রিম বুদ্ধিমত্তার কোনো প্রকল্প শুরু করার সময় আমরা সাধারণত মডেল, অ্যালগরিদম বা কোড নিয়ে বেশি চিন্তা করি। কিন্তু বাস্তবে একটি ভালো মেশিন লার্নিং মডেলের ভিত্তি তৈরি হয় ভালো ডেটাসেট দিয়ে।
আপনি যত উন্নত অ্যালগরিদমই ব্যবহার করেন না কেন, যদি আপনার ডেটা ভুল, অসম্পূর্ণ, অপর্যাপ্ত, অসামঞ্জস্যপূর্ণ বা ভুলভাবে প্রস্তুত করা হয়, তাহলে মডেলের ফলাফলও সমস্যাযুক্ত হতে পারে।
বিশেষ করে গবেষণামূলক প্রকল্পে শুধু ডেটা সংগ্রহ করলেই কাজ শেষ হয় না। সংগৃহীত ডেটাকে বিভিন্ন ধাপে পরিষ্কার, সংগঠিত, লেবেল এবং প্রয়োজনে অগমেন্টেশন করতে হয়।
এই প্রক্রিয়ার দুটি অত্যন্ত গুরুত্বপূর্ণ বিষয় হলো ডেটা লেবেলিং এবং ডেটা অগমেন্টেশন।
সহজভাবে বললে—
ডেটা লেবেলিং হলো ডেটাকে অর্থপূর্ণ পরিচয় দেওয়া।
আর ডেটা অগমেন্টেশন হলো বিদ্যমান ডেটা থেকে বাস্তবসম্মত নতুন বৈচিত্র্য তৈরি করা।
এই লেখায় আমরা শুরু থেকে শেষ পর্যন্ত দেখব—ডেটা লেবেলিং কী, কেন প্রয়োজন, বিভিন্ন ধরনের লেবেলিং কীভাবে করা হয়, ডেটা অগমেন্টেশন কী, কেন করা হয়, কীভাবে করা হয় এবং পাইথন ব্যবহার করে কীভাবে একটি বাস্তব ডেটাসেট প্রস্তুত করা যায়।
১. কাঁচা ডেটা কী?
মেশিন লার্নিং প্রকল্পে ডেটা বিভিন্ন ধরনের হতে পারে। যেমন ছবি, ভিডিও, অডিও, লেখা, সংখ্যাভিত্তিক তথ্য, সেন্সর ডেটা, সময়ভিত্তিক তথ্য এবং বিভিন্ন গবেষণা থেকে সংগৃহীত তথ্য।
ধরুন, আমি একটি গাছের রোগ শনাক্তকরণ ব্যবস্থা তৈরি করছি।
আমি বিভিন্ন গাছের পাতার ছবি সংগ্রহ করলাম।
আমার কাছে এখন এমন অনেক ছবি থাকতে পারে—
পাতা_০০১.jpg পাতা_০০২.jpg পাতা_০০৩.jpg পাতা_০০৪.jpg পাতা_০০৫.jpg
কিন্তু কম্পিউটার জানে না কোনটি সুস্থ পাতা এবং কোনটি রোগাক্রান্ত পাতা।
এই অবস্থার ডেটাকে কাঁচা ডেটা বলা যায়।
কাঁচা ডেটাকে সরাসরি মডেলে ব্যবহার করার পরিবর্তে সাধারণত সেটিকে প্রস্তুত করতে হয়।
২. ডেটাসেট তৈরির সম্পূর্ণ প্রক্রিয়া
একটি সাধারণ মেশিন লার্নিং প্রকল্পে ডেটা প্রস্তুতির প্রক্রিয়াটি এমন হতে পারে—
ডেটা সংগ্রহ ↓ ডেটা পরিষ্কার ↓ ডেটা সংগঠিত করা ↓ ডেটা লেবেলিং ↓ লেবেল যাচাই ↓ প্রশিক্ষণ, যাচাই ও পরীক্ষা ডেটা ভাগ ↓ ডেটা অগমেন্টেশন ↓ মডেল প্রশিক্ষণ ↓ মূল্যায়ন
প্রতিটি ধাপের আলাদা উদ্দেশ্য রয়েছে।
৩. ডেটা লেবেলিং কী?
ডেটা লেবেলিং হলো কোনো কাঁচা ডেটার সঙ্গে এমন তথ্য যুক্ত করা, যা মেশিন লার্নিং মডেলকে বুঝতে সাহায্য করে সেই ডেটা কী নির্দেশ করছে।
সহজ উদাহরণ দেখি।
আমার কাছে তিনটি ছবি আছে—
ছবি ১ ছবি ২ ছবি ৩
আমি যদি জানি—
ছবি ১ → সুস্থ পাতা ছবি ২ → পাতার দাগ রোগ ছবি ৩ → ঝলসানো রোগ
তাহলে আমি ছবিগুলোকে লেবেল করেছি।
অর্থাৎ লেবেলিং মডেলকে বলে দেয় একটি ডেটা কী নির্দেশ করছে।
৪. ডেটা লেবেলিং কেন গুরুত্বপূর্ণ?
মেশিন লার্নিং মডেল উদাহরণ থেকে বিভিন্ন ধরনের সম্পর্ক ও বৈশিষ্ট্য শিখতে পারে। কিন্তু তত্ত্বাবধানে পরিচালিত মেশিন লার্নিংয়ের ক্ষেত্রে প্রশিক্ষণের সময় সঠিক প্রত্যাশিত ফলাফল বা লেবেল থাকা অত্যন্ত গুরুত্বপূর্ণ।
ধরুন আমি ৫,০০০টি পাতার ছবি সংগ্রহ করলাম। কিন্তু কোন ছবিতে কোন রোগ আছে তা জানালাম না।
তাহলে প্রশিক্ষণের সময় মডেলের কাছে সঠিক উত্তর থাকবে না।
অন্যদিকে যদি প্রতিটি ছবির সঙ্গে সঠিক শ্রেণি যুক্ত করি—
ছবি → সুস্থ ছবি → রোগ ছবি → রোগ ছবি → সুস্থ
তাহলে মডেল ইনপুট এবং প্রত্যাশিত ফলাফলের মধ্যে সম্পর্ক শেখার সুযোগ পায়।
তাই সঠিক লেবেল একটি ভালো মেশিন লার্নিং ডেটাসেটের অন্যতম গুরুত্বপূর্ণ অংশ।
৫. ডেটা লেবেলিংয়ের বিভিন্ন ধরন
সমস্যার ধরন অনুযায়ী লেবেলিংয়ের পদ্ধতি পরিবর্তিত হয়।
প্রধান কয়েকটি ধরন হলো—
ক. ছবি শ্রেণিবিন্যাস খ. অবজেক্ট শনাক্তকরণ গ. ছবি বিভাজন ঘ. ভিডিও লেবেলিং ঙ. অডিও লেবেলিং চ. সেন্সর ডেটা লেবেলিং
৬. ছবি শ্রেণিবিন্যাসের লেবেলিং
ধরুন আমি গাছের রোগ শনাক্ত করার জন্য একটি ডেটাসেট তৈরি করছি।
আমার শ্রেণিগুলো হলো—
সুস্থ প্রাথমিক রোগ পাতার দাগ ঝলসানো রোগ
তাহলে প্রতিটি ছবির সঙ্গে একটি শ্রেণি যুক্ত করব।
যেমন—
leaf_001.jpg → সুস্থ leaf_002.jpg → পাতার দাগ leaf_003.jpg → ঝলসানো রোগ leaf_004.jpg → সুস্থ
এখানে পুরো ছবিটিই একটি নির্দিষ্ট শ্রেণির অন্তর্ভুক্ত।
৭. অবজেক্ট শনাক্তকরণের লেবেলিং
একটি ছবিতে যদি একই সঙ্গে অনেকগুলো বস্তু থাকে, তাহলে শুধু পুরো ছবিকে একটি শ্রেণি দেওয়া যথেষ্ট নয়।
ধরুন একটি কৃষিক্ষেত্রের ছবিতে একাধিক পাতা রয়েছে।
আমাদের জানতে হবে প্রতিটি পাতা ছবির ঠিক কোন অংশে রয়েছে।
এই ক্ষেত্রে সাধারণত বাউন্ডিং বক্স ব্যবহার করা হয়।
একটি বাউন্ডিং বক্সের তথ্য সাধারণত বস্তুর অবস্থান এবং শ্রেণি নির্দেশ করে।
যেমন—
শ্রেণি = রোগাক্রান্ত পাতা অবস্থান = নির্দিষ্ট স্থান প্রস্থ = নির্দিষ্ট মান উচ্চতা = নির্দিষ্ট মান
৮. ছবি বিভাজনের লেবেলিং
ছবি বিভাজন বা সেগমেন্টেশন অবজেক্ট শনাক্তকরণের চেয়েও সূক্ষ্ম।
এখানে শুধু একটি বাক্স আঁকা হয় না। বরং ছবির কোন কোন পিক্সেল নির্দিষ্ট বস্তুর অন্তর্ভুক্ত তা চিহ্নিত করা হয়।
সহজভাবে—
শ্রেণিবিন্যাস: এই ছবিতে রোগ আছে।
অবজেক্ট শনাক্তকরণ: এই বাক্সের মধ্যে রোগ আছে।
সেগমেন্টেশন: এই নির্দিষ্ট পিক্সেলগুলোই রোগাক্রান্ত অংশ।
৯. ভিডিও ডেটা লেবেলিং
ভিডিও আসলে অনেকগুলো ফ্রেমের সমষ্টি।
ধরুন একটি ৩০ সেকেন্ডের ভিডিও প্রতি সেকেন্ডে ৩০টি ফ্রেম ধারণ করছে। তাহলে সেখানে প্রায় ৯০০টি ফ্রেম থাকতে পারে।
এখন আমরা প্রতিটি ফ্রেম আলাদাভাবে লেবেল করতে পারি অথবা নির্দিষ্ট সময়ের ঘটনাকে লেবেল করতে পারি।
উদাহরণ—
০০:০৫ – ০০:০৮ → চোখে চোখ রাখা ০০:১২ – ০০:১৬ → নির্দিষ্ট আচরণ ০০:২১ – ০০:২৫ → চোখে চোখ না রাখা
গবেষণার উদ্দেশ্য অনুযায়ী কোন পদ্ধতি ব্যবহার করা হবে তা আগে নির্ধারণ করা উচিত।
১০. সেন্সর ডেটা লেবেলিং
ডেটা লেবেলিং শুধু ছবি বা ভিডিওর জন্য নয়। আইওটি ও সেন্সরভিত্তিক মেশিন লার্নিং প্রকল্পেও এটি অত্যন্ত গুরুত্বপূর্ণ।
ধরুন একটি জল পর্যবেক্ষণ ব্যবস্থা নিচের তথ্য সংগ্রহ করছে—
তাপমাত্রা = ২৮.৪ ডিগ্রি সেলসিয়াস পিএইচ = ৭.২ টিডিএস = ৩২০ ঘোলাভাব = ১৫
এখন এই তথ্যের ভিত্তিতে আমরা একটি ফলাফল বা লেবেল তৈরি করতে পারি—
জলের মান = ভালো
অথবা—
জলের মান = খারাপ
এখানে সেন্সরের মানগুলো হলো ইনপুট এবং জলের মান হলো লক্ষ্য বা লেবেল।
১১. ভালো লেবেলের বৈশিষ্ট্য
একটি গবেষণা ডেটাসেটে লেবেলিং করার সময় কয়েকটি বিষয় খুব গুরুত্বপূর্ণ।
সঠিকতা: লেবেল অবশ্যই প্রকৃত ডেটার সঙ্গে সামঞ্জস্যপূর্ণ হতে হবে।
ধারাবাহিকতা: একই ধরনের ডেটার ক্ষেত্রে একই নিয়ম প্রয়োগ করতে হবে।
স্পষ্টতা: লেবেলিংয়ের নিয়ম এমন হতে হবে যেন বিভিন্ন লেবেলকারী একই ধরনের ডেটায় একই সিদ্ধান্ত নিতে পারে।
পুনরুৎপাদনযোগ্যতা: অন্য একজন গবেষক যেন আপনার লেবেলিং পদ্ধতি বুঝতে পারেন এবং প্রয়োজনে একই ধরনের ফলাফল তৈরি করতে পারেন।
১২. লেবেলিংয়ের আগে নির্দেশিকা তৈরি করুন
গবেষণামূলক প্রকল্পে লেবেলিং শুরু করার আগে একটি পরিষ্কার নির্দেশিকা তৈরি করা অত্যন্ত গুরুত্বপূর্ণ।
ধরুন আমি চোখে চোখ রাখার আচরণ শনাক্ত করার জন্য একটি ডেটাসেট তৈরি করছি।
তাহলে আগে ঠিক করতে হবে—
চোখে চোখ রাখা বলতে কী বোঝানো হবে?
কতক্ষণ তাকালে সেটিকে চোখে চোখ রাখা বলা হবে?
মুখ আংশিক ঢাকা থাকলে কী হবে?
ছবি অস্পষ্ট হলে কী হবে?
চোখ বন্ধ থাকলে কী হবে?
এই নিয়মগুলো আগে নির্ধারণ করলে পুরো ডেটাসেটের লেবেল অনেক বেশি ধারাবাহিক হবে।
১৩. পাইথন দিয়ে সহজ ডেটা লেবেলিং
ছবি শ্রেণিবিন্যাসের ক্ষেত্রে ফোল্ডারের নামকে শ্রেণি হিসেবে ব্যবহার করা যায়।
ডেটাসেটের কাঠামো হতে পারে—
ডেটাসেট/ ├── সুস্থ/ │ ├── ০০১.jpg │ ├── ০০২.jpg │ └── ০০৩.jpg │ └── রোগ/ ├── ০০৪.jpg ├── ০০৫.jpg └── ০০৬.jpg
এখন পাইথন দিয়ে ফাইল এবং শ্রেণির নাম পড়তে পারি।
পাইথনের উদাহরণ:
import os
dataset_path = "dataset"
for class_name in os.listdir(dataset_path): class_path = os.path.join(dataset_path, class_name)
if os.path.isdir(class_path): for image_name in os.listdir(class_path): print(image_name, "→", class_name)
এখানে ফোল্ডারের নামকে লেবেল হিসেবে ব্যবহার করা হচ্ছে।
১৪. সিএসভি ফাইলে লেবেল সংরক্ষণ
আরেকটি জনপ্রিয় পদ্ধতি হলো আলাদা একটি সিএসভি ফাইলে লেবেল সংরক্ষণ করা।
উদাহরণ—
ছবির_নাম,শ্রেণি 001.jpg,সুস্থ 002.jpg,সুস্থ 003.jpg,রোগ 004.jpg,রোগ
পাইথন দিয়ে এটি তৈরি করা যায়।
import csv
data = [ ["001.jpg", "সুস্থ"], ["002.jpg", "সুস্থ"], ["003.jpg", "রোগ"], ["004.jpg", "রোগ"] ]
with open("labels.csv", "w", newline="", encoding="utf-8") as file: writer = csv.writer(file)
writer.writerow(["ছবির_নাম", "শ্রেণি"]) writer.writerows(data)
print("লেবেল ফাইল তৈরি হয়েছে।")
১৫. ডেটা অগমেন্টেশন কী?
এখন আসি দ্বিতীয় গুরুত্বপূর্ণ বিষয়—ডেটা অগমেন্টেশন।
ডেটা অগমেন্টেশন হলো বিদ্যমান ডেটার ওপর বিভিন্ন নিয়ন্ত্রিত এবং বাস্তবসম্মত পরিবর্তন প্রয়োগ করে প্রশিক্ষণের জন্য নতুন বৈচিত্র্য তৈরি করা।
ধরুন আমার কাছে একটি পাতার ছবি আছে।
মূল ছবি
সেখান থেকে আমরা তৈরি করতে পারি—
ঘোরানো ছবি উল্টানো ছবি কাটা ছবি জুম করা ছবি উজ্জ্বলতা পরিবর্তিত ছবি কনট্রাস্ট পরিবর্তিত ছবি
এগুলো হলো অগমেন্টেড ডেটা।
১৬. ডেটা অগমেন্টেশন কেন করা হয়?
বাস্তব পৃথিবীতে একই বস্তু সব সময় একইভাবে দেখা যায় না।
একটি পাতার ছবি কখনো রোদে, কখনো ছায়ায়, কখনো কাছ থেকে, কখনো দূর থেকে এবং বিভিন্ন কোণ থেকে ধারণ করা হতে পারে।
মডেলকে যদি শুধু একই ধরনের পরিষ্কার ছবিতে প্রশিক্ষণ দেওয়া হয়, তাহলে বাস্তব পরিস্থিতিতে তার কর্মক্ষমতা কমে যেতে পারে।
অগমেন্টেশন প্রশিক্ষণ ডেটায় কিছু বাস্তবসম্মত বৈচিত্র্য যোগ করতে সাহায্য করে।
১৭. একটি গুরুত্বপূর্ণ বিষয়
ধরুন আপনার কাছে ১,০০০টি আসল ছবি আছে।
আপনি সেগুলো থেকে বিভিন্ন পরিবর্তনের মাধ্যমে ১০,০০০টি ছবি তৈরি করলেন।
এর অর্থ এই নয় যে আপনার কাছে এখন ১০,০০০টি স্বাধীন বাস্তব নমুনা রয়েছে।
আপনার আসল পর্যবেক্ষণ এখনো ১,০০০টি।
বাকি ছবিগুলো সেই ১,০০০টি নমুনার পরিবর্তিত সংস্করণ।
অর্থাৎ অগমেন্টেশন ডেটার বৈচিত্র্য বাড়ায়, কিন্তু নতুন বাস্তব তথ্য তৈরি করে না।
১৮. ছবির সাধারণ অগমেন্টেশন পদ্ধতি
ঘূর্ণন: ছবিকে সামান্য ডানে বা বামে ঘোরানো।
অনুভূমিক উল্টানো: ছবিকে ডান-বাম উল্টানো।
ক্রপ: ছবির একটি অংশ কেটে নতুন ছবি তৈরি করা।
জুম: ছবিকে সামান্য বড় বা ছোট করে দেখা।
উজ্জ্বলতা পরিবর্তন: ছবিকে সামান্য উজ্জ্বল বা অন্ধকার করা।
কনট্রাস্ট পরিবর্তন: ছবির আলো-ছায়ার পার্থক্য পরিবর্তন করা।
নয়েজ যোগ করা: নিয়ন্ত্রিত মাত্রায় ছবিতে শব্দ বা নয়েজ যোগ করা।
তবে প্রতিটি পদ্ধতি সব ধরনের ডেটার জন্য উপযুক্ত নয়।
১৯. পাইথন দিয়ে ছবির অগমেন্টেশন
পাইথনে একটি ছবি পড়ে সেটিকে ঘোরানোর সহজ উদাহরণ হলো—
from PIL import Image
image = Image.open("leaf.jpg")
rotated = image.rotate(15)
rotated.save("leaf_rotated.jpg")
print("অগমেন্টেড ছবি তৈরি হয়েছে।")
এখানে মূল ছবিকে ১৫ ডিগ্রি ঘোরানো হয়েছে।
২০. একাধিক অগমেন্টেশন একসঙ্গে
একটি ছবির ওপর একাধিক পরিবর্তন করা যায়।
from PIL import Image, ImageEnhance
image = Image.open("leaf.jpg")
image = image.rotate(10)
image = image.transpose( Image.Transpose.FLIP_LEFT_RIGHT )
brightness = ImageEnhance.Brightness(image) image = brightness.enhance(1.2)
image.save("leaf_augmented.jpg")
print("অগমেন্টেশন সম্পন্ন হয়েছে।")
এখানে ছবিকে ঘোরানো, উল্টানো এবং উজ্জ্বলতা পরিবর্তন করা হয়েছে।
২১. অনেকগুলো ছবির স্বয়ংক্রিয় অগমেন্টেশন
ধরুন একটি ফোল্ডারে অনেকগুলো ছবি রয়েছে।
আমরা প্রতিটি ছবির জন্য বিভিন্ন অগমেন্টেড সংস্করণ তৈরি করতে পারি।
import os from PIL import Image, ImageEnhance
input_folder = "original_images" output_folder = "augmented_images"
os.makedirs(output_folder, exist_ok=True)
for filename in os.listdir(input_folder):
if filename.lower().endswith((".jpg", ".jpeg", ".png")):
image_path = os.path.join(input_folder, filename) image = Image.open(image_path)
name, extension = os.path.splitext(filename)
rotated = image.rotate(15) rotated.save( os.path.join( output_folder, f"{name}_rotated{extension}" ) )
flipped = image.transpose( Image.Transpose.FLIP_LEFT_RIGHT )
flipped.save( os.path.join( output_folder, f"{name}_flipped{extension}" ) )
enhancer = ImageEnhance.Brightness(image) bright = enhancer.enhance(1.2)
bright.save( os.path.join( output_folder, f"{name}_bright{extension}" ) )
print("সব ছবির অগমেন্টেশন সম্পন্ন হয়েছে।")
২২. অবজেক্ট শনাক্তকরণের ক্ষেত্রে গুরুত্বপূর্ণ সতর্কতা
ধরুন একটি ছবিতে একটি পাতার চারপাশে একটি বাউন্ডিং বক্স রয়েছে।
আপনি যদি ছবিটি ঘোরান বা উল্টান, তাহলে শুধু ছবিটি পরিবর্তন করলেই হবে না।
বাউন্ডিং বক্সের অবস্থানও একইভাবে পরিবর্তন করতে হবে।
অর্থাৎ—
ছবি পরিবর্তন + বাউন্ডিং বক্স পরিবর্তন = সঠিক অগমেন্টেশন
একই বিষয় সেগমেন্টেশন ডেটার ক্ষেত্রেও প্রযোজ্য। ছবির সঙ্গে সংশ্লিষ্ট মাস্কও একইভাবে পরিবর্তন করতে হবে।
২৩. প্রশিক্ষণ, যাচাই ও পরীক্ষার ডেটা
ডেটাসেট সাধারণত তিন ভাগে ভাগ করা হয়—
প্রশিক্ষণ ডেটা যাচাই ডেটা পরীক্ষা ডেটা
একটি উদাহরণ হতে পারে—
প্রশিক্ষণ → ৭০ শতাংশ যাচাই → ১৫ শতাংশ পরীক্ষা → ১৫ শতাংশ
তবে প্রকল্পের আকার ও গবেষণার পদ্ধতি অনুযায়ী অনুপাত পরিবর্তিত হতে পারে।
মূল বিষয় হলো পরীক্ষার ডেটা এমনভাবে সংরক্ষণ করা যাতে সেটি মডেলের প্রশিক্ষণে ব্যবহৃত তথ্যের সঙ্গে অযাচিতভাবে মিশে না যায়।
২৪. ডেটা লিকেজ কী?
ডেটা লিকেজ হলো এমন একটি সমস্যা যেখানে প্রশিক্ষণের সময় এমন তথ্য মডেল পেয়ে যায় যা আসলে পরীক্ষার জন্য আলাদা থাকার কথা।
ধরুন আমার কাছে একটি মূল ছবি আছে।
আমি সেই ছবি থেকে তৈরি করলাম—
মূল ছবি ঘোরানো ছবি উল্টানো ছবি ক্রপ করা ছবি
যদি মূল ছবিটি প্রশিক্ষণে এবং তার খুব কাছাকাছি পরিবর্তিত সংস্করণ পরীক্ষায় চলে যায়, তাহলে পরীক্ষার ডেটা আর পুরোপুরি নতুন থাকে না।
ফলে মডেলের ফলাফল বাস্তবের তুলনায় ভালো দেখাতে পারে।
তাই সাধারণভাবে সঠিক পদ্ধতি হলো—
মূল ডেটা ↓ প্রশিক্ষণ / যাচাই / পরীক্ষা ভাগ ↓ শুধুমাত্র প্রশিক্ষণ ডেটায় অগমেন্টেশন
২৫. ভিডিও ডেটার ক্ষেত্রে ডেটা লিকেজ
ভিডিও ডেটায় এই বিষয়টি আরও গুরুত্বপূর্ণ।
ধরুন একজন ব্যক্তির একটি ভিডিও থেকে হাজার হাজার ফ্রেম নেওয়া হয়েছে।
যদি একই ব্যক্তির একই ভিডিওর কিছু ফ্রেম প্রশিক্ষণে এবং কিছু ফ্রেম পরীক্ষায় চলে যায়, তাহলে পরীক্ষার ফলাফল বাস্তব পরিস্থিতির তুলনায় বেশি ভালো দেখাতে পারে।
তাই গবেষণার ধরন অনুযায়ী ব্যক্তি-ভিত্তিক বা উৎস-ভিত্তিক ডেটা ভাগ করা অধিক উপযুক্ত হতে পারে।
২৬. ডেটা অগমেন্টেশনের সাধারণ ভুল
প্রথম ভুল হলো অতিরিক্ত অগমেন্টেশন।
প্রয়োজনের চেয়ে বেশি পরিবর্তন করলে ডেটা বাস্তবতার কাছ থেকে দূরে চলে যেতে পারে।
দ্বিতীয় ভুল হলো অবাস্তব পরিবর্তন।
এমন নমুনা তৈরি করা উচিত নয় যা বাস্তব পৃথিবীতে প্রায় কখনোই দেখা যায় না।
তৃতীয় ভুল হলো পরীক্ষার ডেটা অগমেন্ট করা।
চতুর্থ ভুল হলো অ্যানোটেশন পরিবর্তন না করে ছবি পরিবর্তন করা।
বিশেষ করে অবজেক্ট শনাক্তকরণ ও সেগমেন্টেশনের ক্ষেত্রে এটি অত্যন্ত গুরুত্বপূর্ণ।
২৭. শ্রেণির ভারসাম্য
ধরুন আপনার ডেটাসেটে আছে—
সুস্থ → ৫,০০০টি রোগ → ৫০০টি
এখানে দুই শ্রেণির মধ্যে বড় পার্থক্য রয়েছে।
এই অবস্থায় মডেল সংখ্যাগরিষ্ঠ শ্রেণির দিকে বেশি ঝুঁকে যেতে পারে।
প্রশিক্ষণ ডেটায় কম প্রতিনিধিত্ব করা শ্রেণির বৈচিত্র্য বাড়ানোর জন্য অগমেন্টেশন ব্যবহার করা যেতে পারে।
তবে শুধু অগমেন্টেশন করলেই শ্রেণির ভারসাম্যের সব সমস্যা সমাধান হয় না।
প্রয়োজনে নতুন বাস্তব ডেটা সংগ্রহ, শ্রেণি-ওজন এবং অন্যান্য উপযুক্ত পদ্ধতিও ব্যবহার করা যেতে পারে।
২৮. গবেষণার জন্য ডেটাসেট সংস্করণ রাখা
গবেষণামূলক প্রকল্পে ডেটাসেটের বিভিন্ন সংস্করণ সংরক্ষণ করা খুবই উপকারী।
যেমন—
ডেটাসেট ১.০ → কাঁচা ডেটা
ডেটাসেট ১.১ → পরিষ্কার করা ডেটা
ডেটাসেট ১.২ → লেবেল করা ডেটা
ডেটাসেট ১.৩ → সংশোধিত লেবেল
ডেটাসেট ২.০ → চূড়ান্ত প্রশিক্ষণ, যাচাই ও পরীক্ষা ডেটা
এতে পরে কোনো ভুল হলে আগের সংস্করণে ফিরে যাওয়া সহজ হয়।
২৯. একটি ভালো ডেটাসেটের ফোল্ডার কাঠামো
একটি গবেষণামূলক ডেটাসেটের কাঠামো এমন হতে পারে—
dataset/ │ ├── raw/ ├── cleaned/ ├── labeled/ ├── train/ ├── validation/ ├── test/ ├── augmented/ ├── annotations/ └── metadata/
প্রকল্পের ধরন অনুযায়ী এই কাঠামো পরিবর্তন করা যেতে পারে।
৩০. ডেটাসেটের সঙ্গে মেটাডেটা রাখা
শুধু ছবি বা ভিডিও রাখলেই গবেষণামূলক ডেটাসেট সম্পূর্ণ হয় না।
প্রয়োজনে নিচের তথ্যগুলো রাখা যেতে পারে—
ডেটা আইডি ফাইলের নাম শ্রেণি সংগ্রহের তারিখ ডিভাইস ডেটা সংগ্রহের উৎস অ্যানোটেটর অ্যানোটেশন সংস্করণ
তবে ব্যক্তিগত বা সংবেদনশীল তথ্য অপ্রয়োজনীয়ভাবে সংগ্রহ করা উচিত নয়।
৩১. ডেটা লেবেলিংয়ের জন্য বিভিন্ন টুল
বিভিন্ন ধরনের ডেটার জন্য বিভিন্ন অ্যানোটেশন টুল ব্যবহার করা যায়।
ছবি ও ভিডিও অ্যানোটেশনের জন্য সিভিএটি, লেবেল স্টুডিও, লেবেল ইমেজ, রোবোফ্লো এবং অন্যান্য টুল ব্যবহার করা যেতে পারে।
কোন টুল ব্যবহার করা হবে তা নির্ভর করবে ডেটার ধরন, প্রকল্পের আকার, অ্যানোটেশনের ধরন এবং মডেলের প্রয়োজনীয়তার ওপর।
৩২. একটি বাস্তব উদাহরণ
ধরুন আমি টমেটো পাতার রোগ শনাক্তকরণ নিয়ে গবেষণা করছি।
আমি মাঠ থেকে মোট ২,০০০টি ছবি সংগ্রহ করলাম।
প্রথমে—
২,০০০টি কাঁচা ছবি
এরপর খারাপ ও অপ্রাসঙ্গিক ছবি বাদ দিলাম।
১,৮৫০টি ব্যবহারযোগ্য ছবি
তারপর লেবেল করলাম—
সুস্থ → ৭০০ রোগ ১ → ৫০০ রোগ ২ → ৪০০ রোগ ৩ → ২৫০
এরপর ডেটাসেট যাচাই করলাম।
তারপর প্রশিক্ষণ, যাচাই ও পরীক্ষার ডেটায় ভাগ করলাম।
এরপর শুধুমাত্র প্রশিক্ষণ ডেটায় অগমেন্টেশন করলাম।
যেমন—
ঘূর্ণন উল্টানো ক্রপ উজ্জ্বলতা পরিবর্তন কনট্রাস্ট পরিবর্তন
তারপর সেই প্রশিক্ষণ ডেটা দিয়ে মডেল প্রশিক্ষণ দিলাম।
সবশেষে পরীক্ষার ডেটা ব্যবহার করে মডেলের কার্যকারিতা মূল্যায়ন করলাম।
৩৩. ডেটা লেবেলিং বনাম ডেটা অগমেন্টেশন
দুটির পার্থক্য খুব সহজভাবে মনে রাখা যায়।
ডেটা লেবেলিং: ডেটার অর্থ নির্ধারণ করে।
ডেটা অগমেন্টেশন: ডেটার বাস্তবসম্মত বৈচিত্র্য বৃদ্ধি করে।
উদাহরণ—
লেবেলিং: ছবি → রোগ
অগমেন্টেশন: ছবি → ঘোরানো ছবি ছবি → উল্টানো ছবি ছবি → উজ্জ্বলতা পরিবর্তিত ছবি
সবচেয়ে সহজভাবে মনে রাখুন—
লেবেলিং বলে: "এটা কী?"
অগমেন্টেশন বলে: "এটা বাস্তবে আর কী কীভাবে দেখা যেতে পারে?"
৩৪. আমার প্রস্তাবিত সম্পূর্ণ ডেটাসেট প্রস্তুতি পদ্ধতি
আমি যদি নতুন কোনো গবেষণা প্রকল্প শুরু করি, তাহলে আমার ডেটা প্রস্তুতির প্রক্রিয়াটি এমন হতে পারে—
১. গবেষণার সমস্যা নির্ধারণ ২. ডেটা সংগ্রহ ৩. কাঁচা ডেটা সংরক্ষণ ৪. ডেটা পরিষ্কার ৫. লেবেলিং নির্দেশিকা তৈরি ৬. ডেটা লেবেলিং ৭. লেবেল যাচাই ৮. প্রশিক্ষণ, যাচাই ও পরীক্ষা ডেটা ভাগ ৯. শুধুমাত্র প্রশিক্ষণ ডেটা অগমেন্ট ১০. মডেল প্রশিক্ষণ ১১. যাচাই ১২. পরীক্ষার ডেটা দিয়ে চূড়ান্ত মূল্যায়ন
৩৫. শেষ কথা
মেশিন লার্নিং শেখার সময় আমরা প্রায়ই মডেল এবং অ্যালগরিদম নিয়ে বেশি চিন্তা করি।
কিন্তু বাস্তবে একটি ভালো মেশিন লার্নিং মডেলের পেছনে একটি ভালো ডেটাসেটের ভূমিকা অত্যন্ত গুরুত্বপূর্ণ।
ডেটা লেবেলিং আমাদের ডেটাকে অর্থ দেয়।
ডেটা অগমেন্টেশন আমাদের প্রশিক্ষণ ডেটায় বাস্তবসম্মত বৈচিত্র্য তৈরি করতে সাহায্য করে।
তবে দুটির কোনোটিই অন্ধভাবে করা উচিত নয়।
সঠিক পদ্ধতি হলো—
ভালো ডেটা সংগ্রহ + সঠিক লেবেলিং + ভালো মান নিয়ন্ত্রণ + সঠিক ডেটাসেট বিভাজন + বাস্তবসম্মত অগমেন্টেশন + ডেটা লিকেজ প্রতিরোধ = একটি শক্তিশালী মেশিন লার্নিং ডেটাসেট
সবচেয়ে গুরুত্বপূর্ণ বিষয় হলো—অগমেন্টেড ডেটার পরিমাণ নয়, ডেটার গুণগত মান এবং বাস্তবতার সঙ্গে সামঞ্জস্য বেশি গুরুত্বপূর্ণ।
গবেষণার ক্ষেত্রে শুধু ডেটাসেট তৈরি করাই যথেষ্ট নয়। কীভাবে ডেটা সংগ্রহ করা হয়েছে, কীভাবে লেবেল করা হয়েছে, কীভাবে অগমেন্ট করা হয়েছে এবং কীভাবে প্রশিক্ষণ ও পরীক্ষার ডেটা আলাদা করা হয়েছে—সবকিছু নথিভুক্ত করা উচিত।
কারণ একটি ভালো গবেষণার জন্য শুধু ভালো মডেল নয়, ভালোভাবে প্রস্তুত করা, যাচাইযোগ্য এবং পুনরুৎপাদনযোগ্য ডেটাসেটও প্রয়োজন।